October 2025
Intermediate to advanced
878 pages
12h 53m
Chinese
本作品已使用人工智能进行翻译。欢迎您提供反馈和意见:translation-feedback@oreilly.com
许多 机器学习问题涉及每个训练实例的数千甚至数百万个特征。所有这些特征不仅会使训练速度变得极其缓慢,而且还会使找到一个好的解决方案变得更加困难,正如你将看到的那样。这个问题通常被称为 "维度诅咒"。
幸运的是,在实际问题中,通常可以大大减少特征的数量,从而将棘手的问题变成容易解决的问题。例如,考虑一下 MNIST 图像(在第 3 章中介绍过):图像边界上的像素几乎总是白色的,因此可以将这些像素从训练集中完全删除,而不会丢失太多信息。正如我们在前一章中看到的,图 6-6证实了这些像素对于分类任务来说完全不重要。此外,相邻的两个像素往往高度相关:如果将它们合并为一个像素(例如,取两个像素强度的平均值),就不会丢失太多信息,还能去除冗余,有时甚至是噪音。
降维也会丢掉一些有用的信息,就像把图像压缩成 JPEG 格式会降低其质量一样: ,尤其是如果降维过多,可能会使系统性能稍差。此外,有些模型--比如神经网络--可以高效处理高维数据,并学会降低维度,同时保留对当前任务有用的信息。简而言之,为降维增加额外的预处理步骤并不总是有帮助的。
除了加快训练速度并可能提高模型性能外,降维 对数据可视化也非常有用。将维数降到二维(或三维)后,就可以在图表上绘制出高维训练集的浓缩视图,通过直观地发现聚类等模式,往往能获得一些重要的见解。此外,数据可视化对于向非数据科学家的人--尤其是将会使用你的结果的决策者--传达你的结论至关重要。
在本章中,我们将首先讨论维度诅咒,了解高维空间中的情况。然后,我们将考虑两种主要的降维方法(投影和流形学习),并将介绍三种最流行的降维技术:PCA、随机投影和局部线性嵌入(LLE)。
我们 太习惯于在三维空间中生活了1当我们试图想象一个高维空间时,我们的直觉就会失灵。即使是一个基本的四维超立方体,我们也很难在脑海中想象出来(见图 7-1),更不用说在 1000 维空间中弯曲的 200 维椭圆体了。
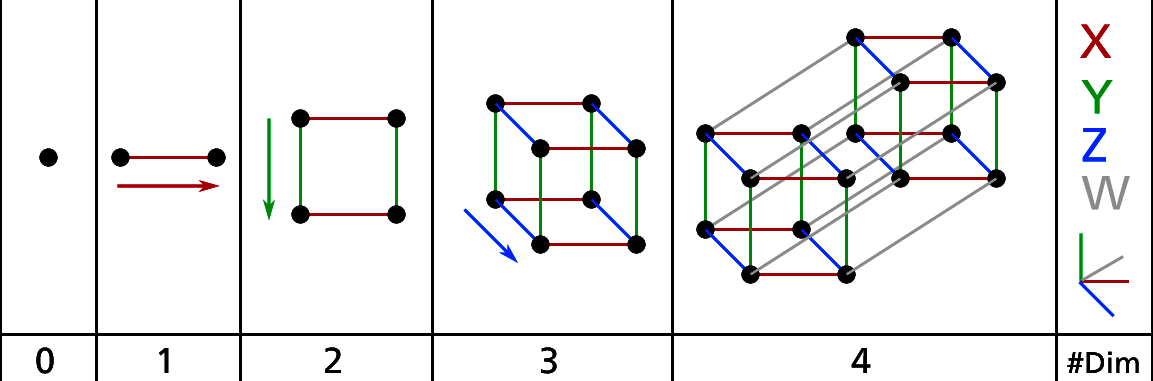
事实证明,许多事物在高维空间中的表现都大相径庭。例如,如果在一个单位正方形(1 × 1 正方形)中随机选取一个点,那么这个点距离边界小于 0.001 的概率大约只有 0.4%(换句话说,一个随机点在任何维度上都不太可能 "极端")。但在一个 10,000 维的单位超立方体中,这个概率大于 99.999999%。高维超立方体中的大多数点都非常接近边界。3
这里有一个更麻烦的区别:如果在单位正方形中随机选取两个点,这两个点之间的距离平均约为 0.52。如果在三维单位立方体中随机选取两个点,平均距离大约为 0.66。那么,在 1,000,000 维单位超立方体中随机选取两个点呢?信不信由你,平均距离大约为 408.25(约为 )!这与直觉相反:两个点都在同一个单位超立方体中,怎么会相距这么远呢?高维数据集的空间非常大。
因此,高维数据集通常非常稀疏:大多数训练实例可能彼此相距甚远,因此基于距离或相似性的训练方法(如k 近邻)的效果会大打折扣。某些类型的模型根本无法使用,因为它们在数据集的维度上扩展能力很差(例如 ...
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.