April 2026
Intermediate
292 pages
4h 39m
Korean
이 작품은 AI를 사용하여 번역되었습니다. 여러분의 피드백과 의견을 환영합니다: translation-feedback@oreilly.com
본질적으로 벡터 임베딩은 컴퓨팅 분야의 근본적인 과제, 즉 복잡하고 구조화되지 않은 데이터를 기계가 이해하고 효율적으로 처리할 수 있는 방식으로 표현하는 방법을 해결합니다. 이 장에서는 벡터 임베딩의 역사, 발전 과정, 그리고 현재 활용 사례를 심도 있게 살펴보고, 언어 모델에서의 적용 예를 보여주는 코드 예제를 다룹니다. 이는 개념적으로 심도 있는 주제이므로, 이후 장에서 임베딩을 적용하기 시작할 때 낯선 용어나 개념에 직면하면 이 내용을 한 번 이상 다시 찾아보게 될 수도 있습니다.
기존의 데이터 구조는 숫자, 날짜, 범주형 값과 같은 구조화된 정보에는 효과적이지만, 인간이 자연스럽게 생성하고 소비하는 텍스트, 이미지, 오디오, 비디오와 같은 풍부하고 미묘한 내용을 다룰 때는 한계가 있습니다. 임베딩은 원시 데이터를 데이터 내의 의미와 관계를 포착하는 벡터(순서화된 숫자 목록)로 매핑함으로써 이러한 격차를 해소합니다( 그림 2-1 참조).
비정형 데이터를 수학적 벡터로 변환하는 이 과정은 단순히 기술적인 편의성을 위한 것이 아닙니다. 이는 LLMs(대규모 언어 모델)과 생성형 AI를 포함한 현대 AI 시스템이 인간의 이해 수준에 근접한 방식으로 정보를 처리하고 이해할 수 있게 하는 토대입니다. 수작업으로 생성된 통계에 기반한 기존의 특징 벡터와 달리, 임베딩은 벡터 공간 내의 근접성이 의미적 또는 개념적 유사성을 반영하는 학습된 표현입니다. 이러한 의미에서 구조로의 매핑은 임베딩(즉, 벡터 공간으로 매핑)되는 대상에 따라 알고리즘이나 전용 언어 모델에 입력된 대규모 텍스트 코퍼스를 통해 훈련함으로써 이루어집니다.
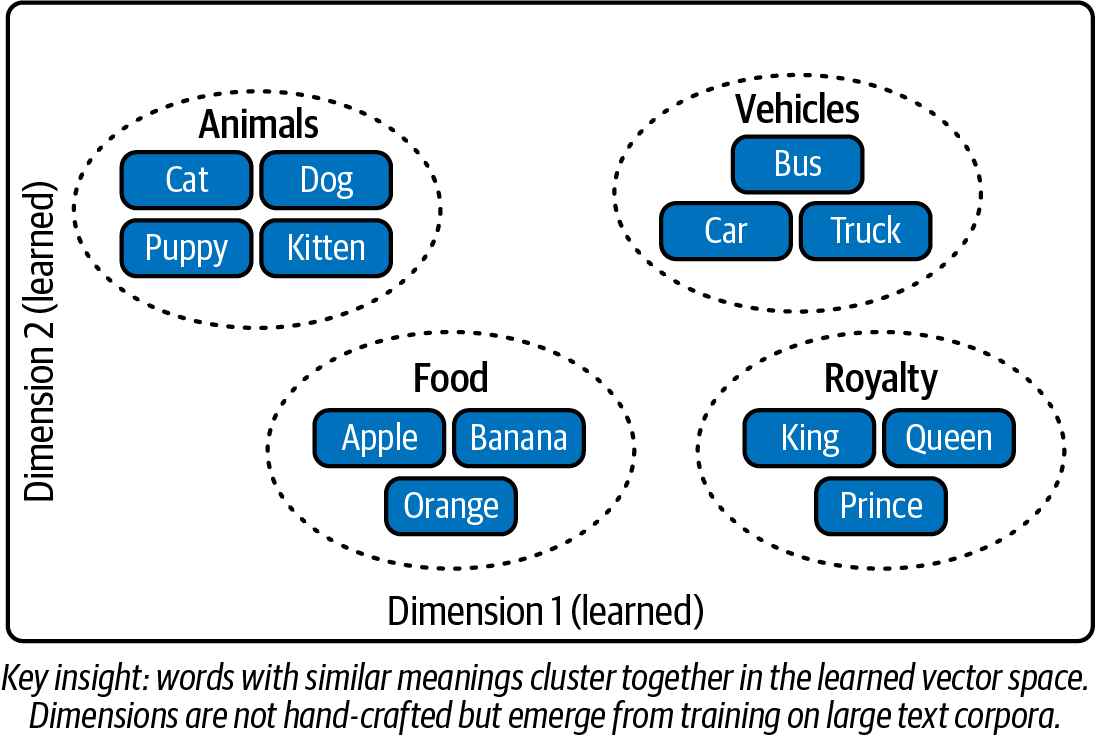
벡터 데이터베이스는 이러한 임베딩을 효율적으로 저장하고 쿼리하기 위한 전문 시스템으로 등장했으며, 대규모로 유사한 벡터(그리고 더 나아가 유사한 콘텐츠)를 찾는 내장 기능을 제공합니다. 이는 우리가 정보를 검색하고 분석하는 방식에 있어 근본적인 변화를 의미합니다. 정확한 키워드 일치나 경직된 범주형 필터에 의존하는 대신, 벡터 임베딩은 의미에 따른 검색, 즉의미적 유사성( )을 기반으로 한 검색을 가능하게 합니다. 예를 들어, “바다의 일몰”을 검색하면 라벨이 다르게 지정된 이미지라도 관련 이미지를 찾을 수 있습니다. 마찬가지로, “재생 에너지 솔루션”에 대한 쿼리는 정확한 구문 일치 없이도 태양광 및 풍력 발전에 대해 논의하는 문서를 찾아낼 수 있습니다. 유사 벡터를 빠르고 효율적으로 찾는 이러한 능력 덕분에 벡터 데이터베이스는 현대 AI 애플리케이션을 위한 필수 인프라가 되었습니다.
임베딩의 영향력은 향상된 검색 기능을 훨씬 ...
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.