July 2025
Intermediate to advanced
320 pages
3h 10m
Chinese
本作品已使用人工智能进行翻译。欢迎您提供反馈和意见:translation-feedback@oreilly.com
我们需要处理缺失数据。上一章展示了一个例子。本章将对此进行深入探讨。如果数据缺失,大多数算法都无法工作。最近的提升库是一个显著的例外:XGBoost、CatBoost 和 LightGBM。
与机器学习中的许多事情一样,如何处理缺失数据并没有硬性答案。而且,缺失数据可能代表不同的情况。想象一下,人口普查数据回来后,年龄特征被报告为缺失。是因为样本不想透露自己的年龄吗?他们不知道自己的年龄?提问的人甚至忘了问年龄?年龄缺失是否有规律可循?是否与其他特征相关?是否完全随机?
处理缺失数据也有多种方法:
删除任何数据缺失的行
删除任何有缺失数据的列
估算缺失值
创建一个指标列来表示数据缺失
让我们回到泰坦尼克号的数据。由于 Python 将True 和False 分别视为1 和0 ,因此我们可以在 pandas 中使用这一技巧来获取缺失数据的百分比:
>>>df.isnull().mean()*100pclass 0.000000survived 0.000000name 0.000000sex 0.000000age 20.091673sibsp 0.000000parch 0.000000ticket 0.000000fare 0.076394cabin 77.463713embarked 0.152788boat 62.872422body 90.756303home.dest 43.086325dtype: float64
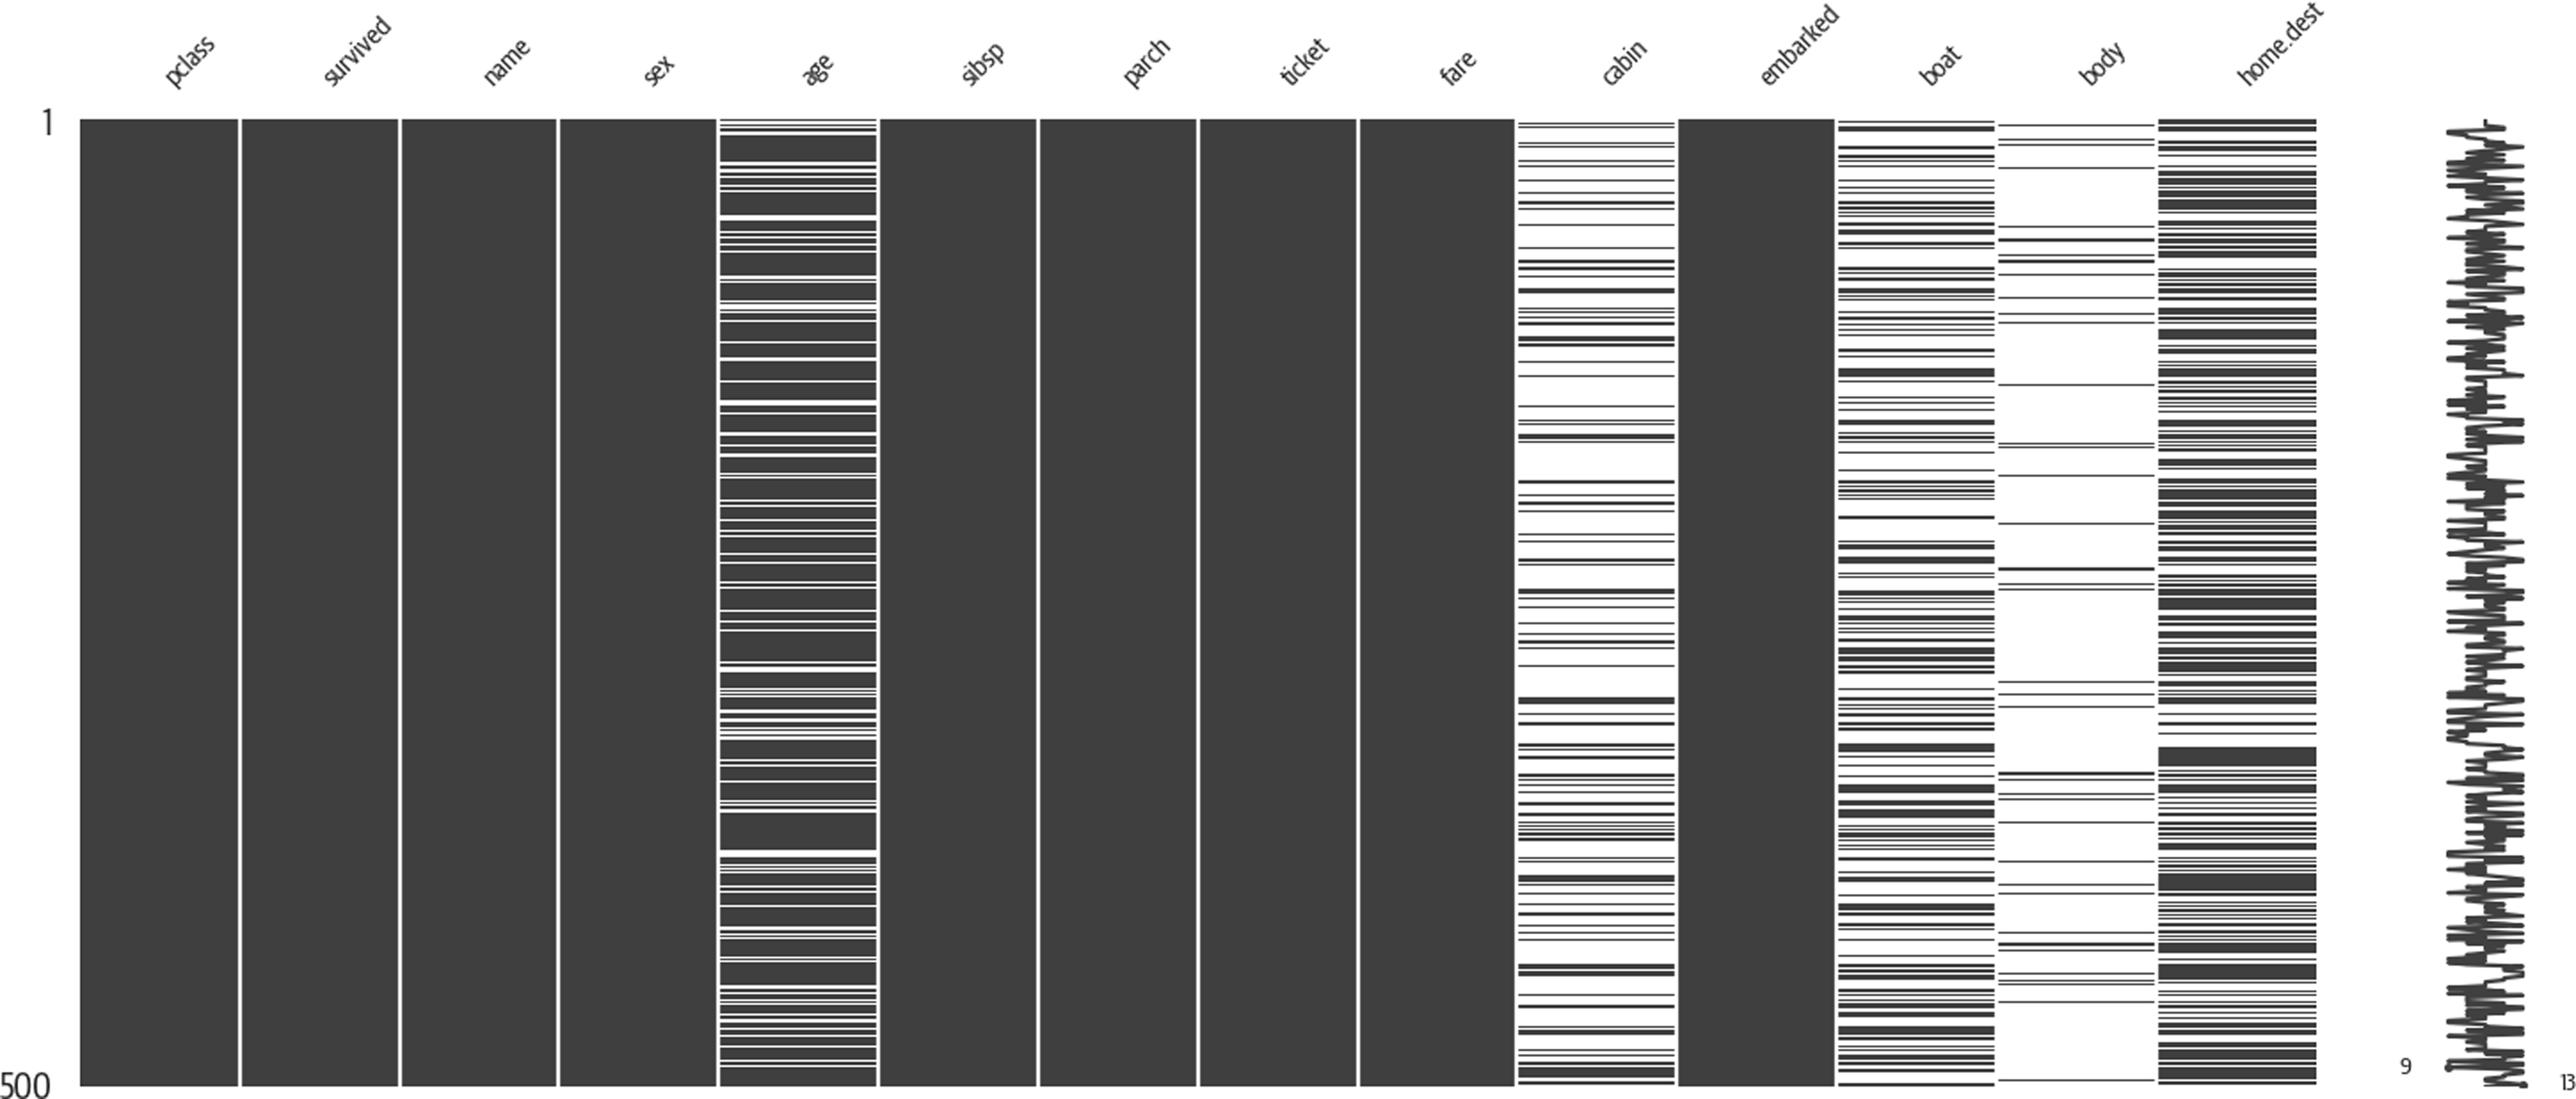
要可视化缺失数据的模式,请使用missingno 库。该库有助于查看连续的缺失数据区域,这表明缺失数据不是随机的(见图 4-1)。matrix 函数右侧有一条火花线。这里的模式也表明缺失数据不是随机的。您可能需要限制样本数量,以便能够看到这些模式:
>>>importmissingnoasmsno>>>ax=msno.matrix(orig_df.sample(500))>>>ax.get_figure().savefig("images/mlpr_0401.png")
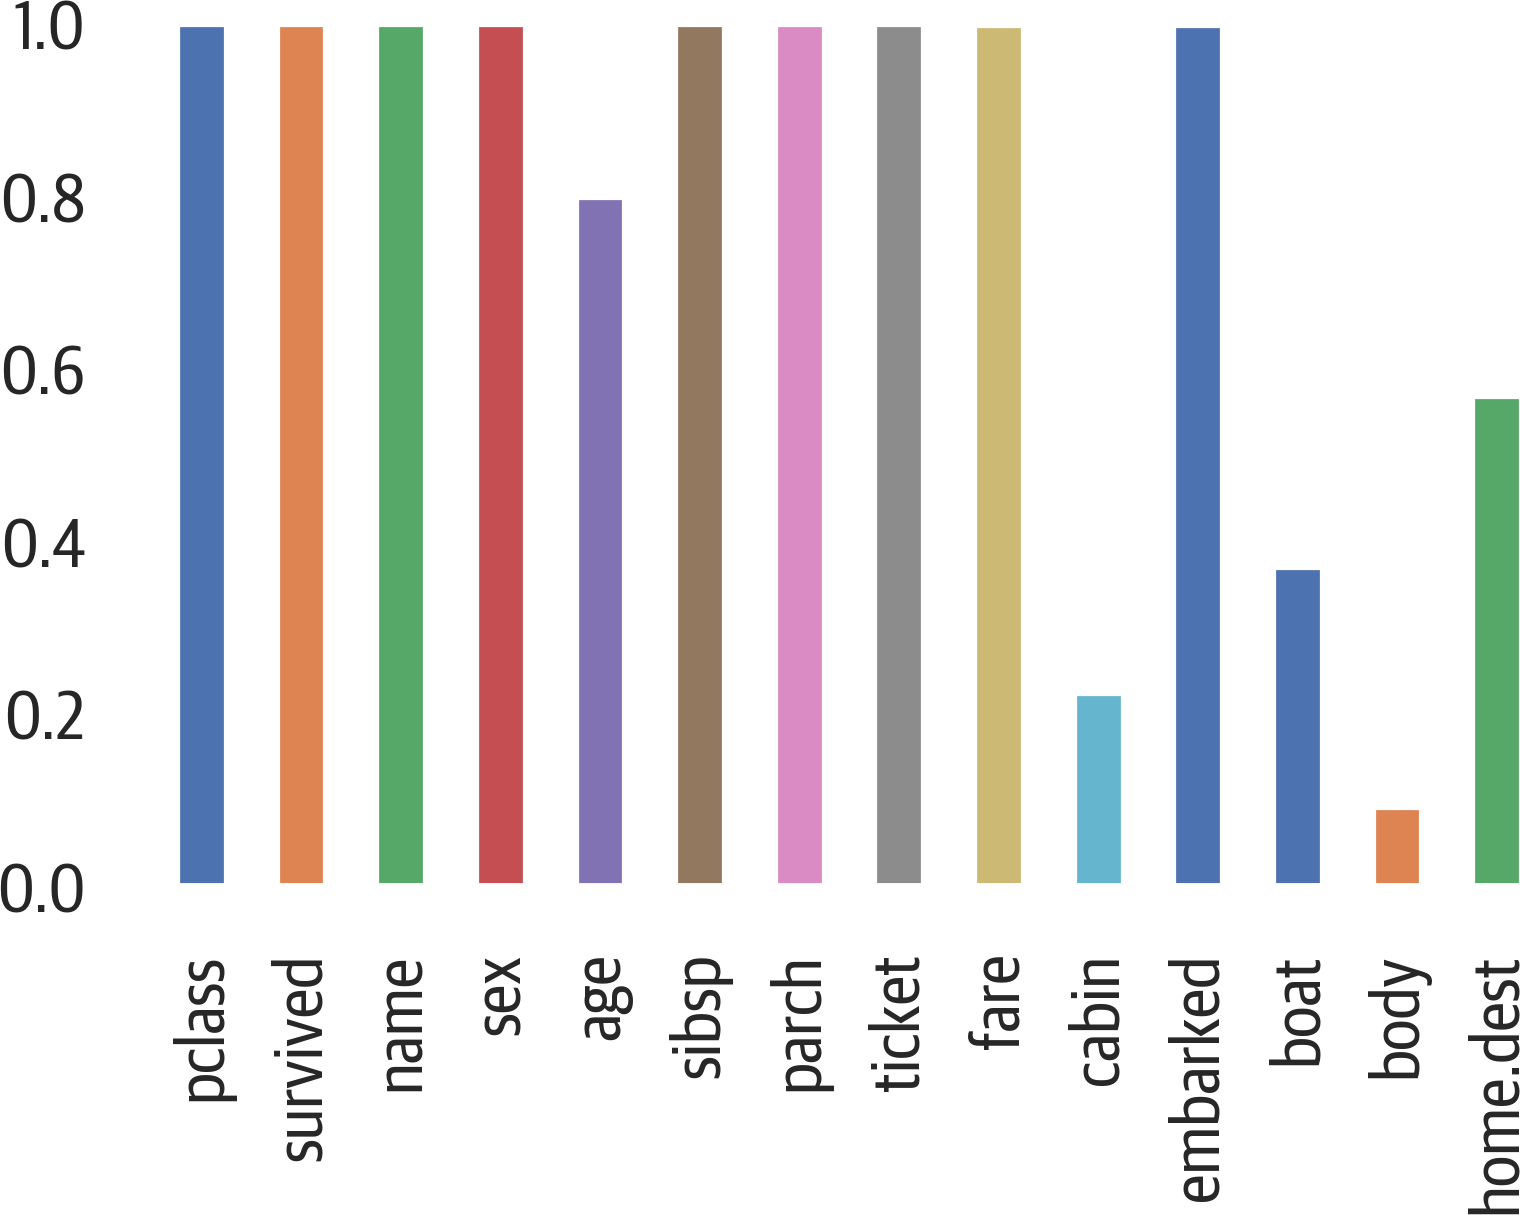
我们可以使用 pandas 创建缺失数据计数的条形图(见图 4-2):
>>>fig,ax=plt.subplots(figsize=(6,4))>>>(1-df.isnull().mean()).abs().plot.bar(ax=ax)>>>fig.savefig("images/mlpr_0402.png",dpi=300)
或者使用 missingno 库创建相同的曲线图(见图 4-3):
>>>ax=msno.bar
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.