July 2025
Intermediate to advanced
320 pages
3h 10m
Chinese
本作品已使用人工智能进行翻译。欢迎您提供反馈和意见:translation-feedback@oreilly.com
用于解释分类模型的大多数技术都适用于回归模型。在本章中,我将展示如何使用 SHAP 库来解释回归模型。
我们将解释波士顿住房数据集的 XGBoost 模型:
>>>importxgboostasxgb>>>xgr=xgb.XGBRegressor(...random_state=42,base_score=0.5...)>>>xgr.fit(bos_X_train,bos_y_train)
我是 Shapley 的忠实粉丝,因为它与模型无关。这个库还能让我们全面了解我们的模型,并帮助解释单个预测。如果你有一个黑盒模型,我觉得它非常有用。
我们首先来看指数 5 的预测。我们的模型预测值为 27.26:
>>>sample_idx=5>>>xgr.predict(bos_X.iloc[[sample_idx]])array([27.269186], dtype=float32)
要使用该模型,我们必须根据模型创建一个TreeExplainer ,并估算样本的 SHAP 值。如果我们想使用 Jupyter 并拥有交互式界面,还需要调用initjs 函数:
>>>importshap>>>shap.initjs()>>>exp=shap.TreeExplainer(xgr)>>>vals=exp.shap_values(bos_X)
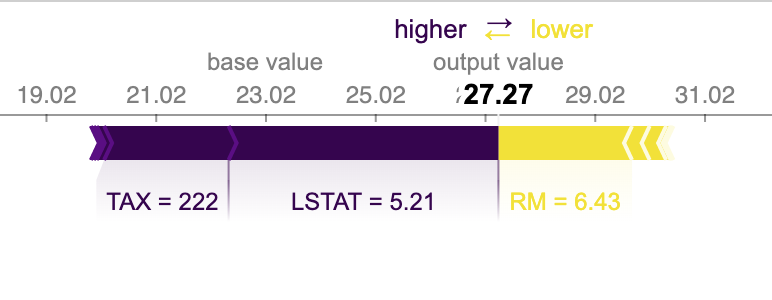
有了解释器和 SHAP 值,我们就可以创建力图来解释预测结果(见图 16-1)。这告诉我们基本预测值是 23,人口状况 (LSTAT) 和房产税税率 (TAX) 会推高价格,而房间数 (RM) 会推低价格:
>>>shap.force_plot(...exp.expected_value,...vals[sample_idx],...bos_X.iloc[sample_idx],...)
我们还可以查看所有样本的力图,以获得行为的总体感觉。如果我们使用的是 Jupyter 上的 JavaScript 交互模式,我们可以将鼠标移到样本上,看看是哪些特征影响了结果(见图 16-2):
>>>shap.force_plot(...exp.expected_value,vals,bos_X...)
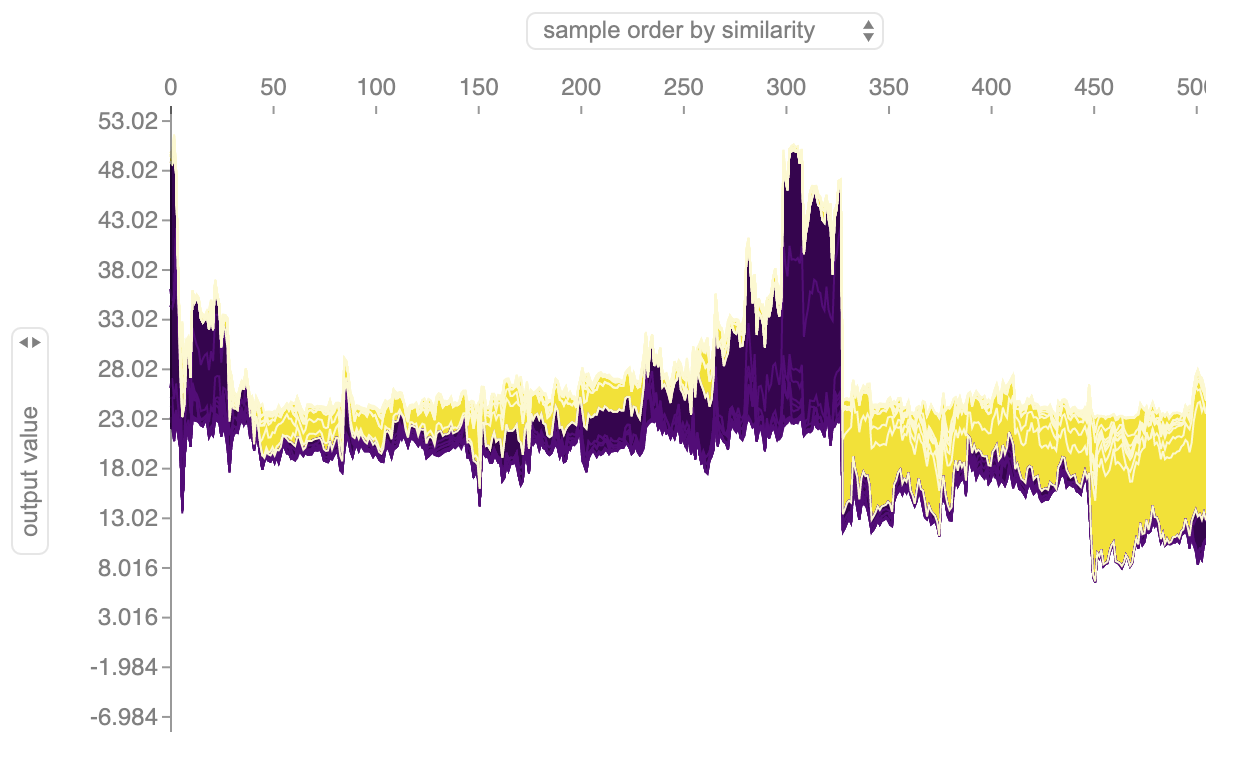
从样本的力图中,我们可以看到 LSTAT 功能产生了很大的影响。为了直观地显示 LSTAT 对结果的影响,我们可以创建依赖关系图。图库会自动选择一个特征来着色(您可以提供interaction_index 参数来设置自己的特征)。
从 LSTAT 的依存图(见图 16-3)中,我们可以看到随着 LSTAT 的增加(地位较低人口的百分比),SHAP 值会下降(推低目标值)。极低的 ...
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.