September 2026
Intermediate
450 pages
7h 51m
Korean
이 작품은 AI를 사용하여 번역되었습니다. 여러분의 피드백과 의견을 환영합니다: translation-feedback@oreilly.com
확장된 LLM에 추가된 모든 모듈 중에서 , 기억은 LLM을 에이전트로 발전시키는 데 필요한 핵심 구성 요소입니다. LLM 자체는 기억력이 부족한 존재입니다. 과거의 대화를 기억하지도 못하고, 자신이 수행한 모든 행동에 접근할 수도 없습니다. 만약 로컬에서 LLM을 실행하여 자신의 이름을 기억해 달라고 요청하더라도, 명시적으로 기억 기능을 부여하지 않는 한 LLM은 이를 기억할 수 없습니다. 반면, ChatGPT나 Claude와 같은 호스팅된 LLMs과 상호작용할 때는 일반적인 LLM과는 다릅니다. 오히려 이들은 기억력이나 도구와 같은 모듈이 강화된 LLM입니다. 그림 4-1은 일반적인 LLM과의 상호작용을 보여줌으로써 이러한 ‘잊어버리는 성질’을 잘 설명해 줍니다. 따라서 LLMs은 상태가 없으며, 호출 간에 정보가 지속되지 않습니다.
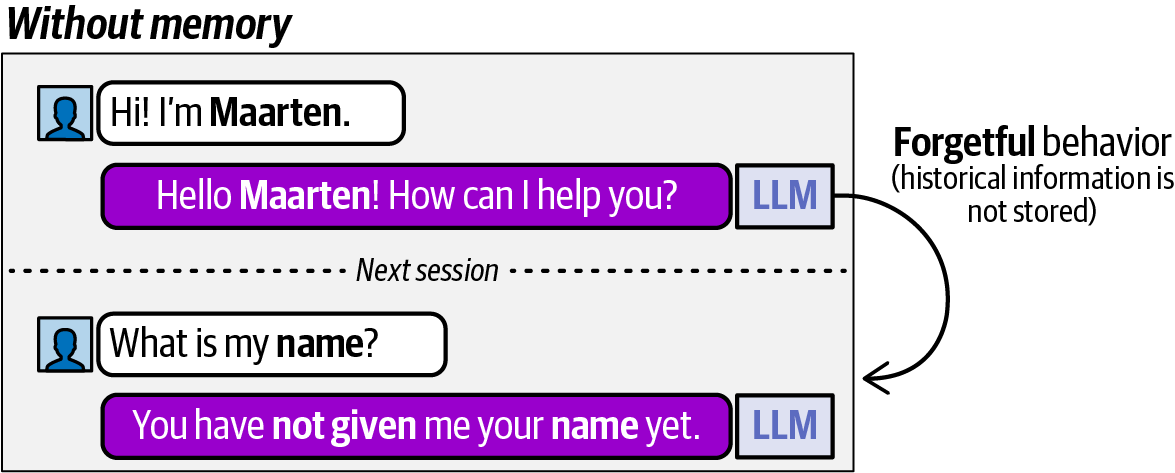
지난 몇 년간 도구 사용, 추론형 LLMs, 다중 에이전트 협업과 같은 에이전트의 측면들에 상당한 관심이 집중되어 왔습니다. 각각은 그 자체로 매우 중요하지만, 기억의 중요성을 과소평가해서는 안 됩니다. 기억이 없다면 개인 비서 에이전트는 과거 대화를 기억할 수 없을 것입니다. 기억이 없다면 코딩 에이전트는 사용자의 전체 코드베이스를 이해할 수 없을 것입니다. 기억이 없다면 에이전트는 이미 수행한 행동을 잊어버리고 계속해서 반복하게 될 것입니다.
기억을 정의하는 것은 꽤 어려울 수 있습니다. 좁은 관점에서 보면, 이는 에이전트 실행 중의 모든 과거 정보와 관련될 수 있습니다. 그러나 이 장에서는 더 넓은 관점을 취합니다. 기억은 에이전트의 모든 과거 행동뿐만 아니라, 에이전트와 환경 간의 상호작용을 넘어서는 외부 정보와도 관련이 있습니다. 코딩 에이전트의 기억은 버그를 수정하기 위해 취한 행동뿐만 아니라, 호스팅된 문서와 이슈 페이지도 포함할 것입니다.
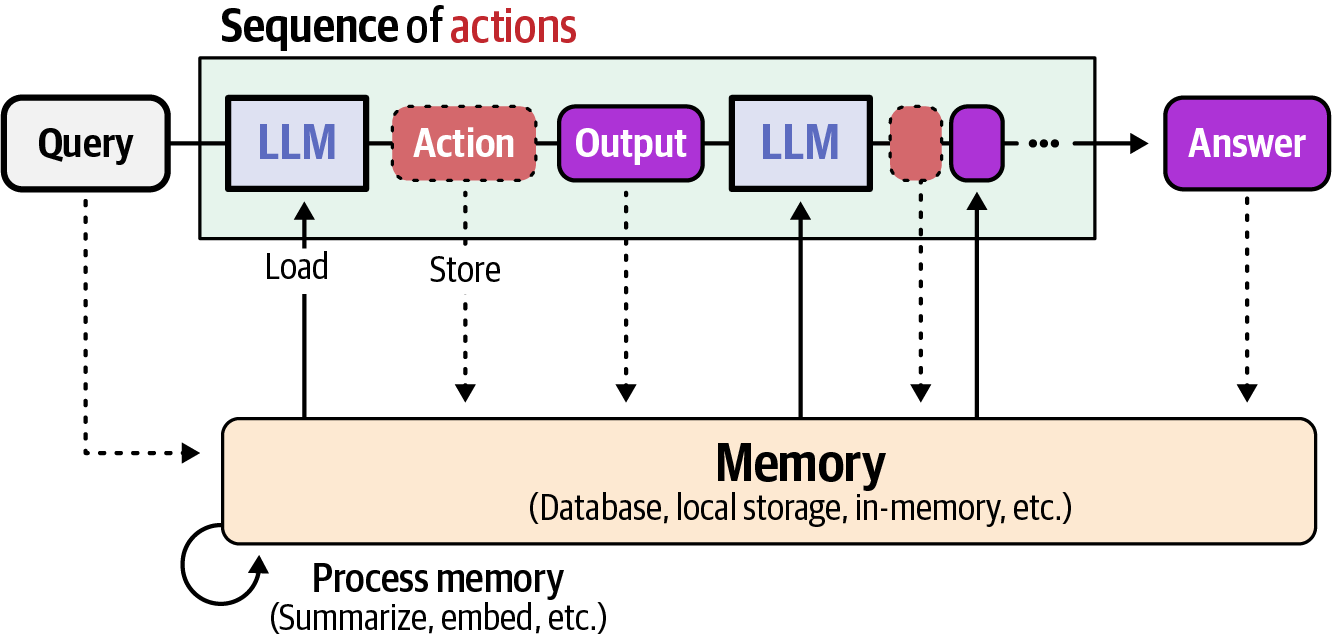
기억이란 단순히 정보를 기억하는 행위뿐만 아니라 새로 생성된 정보를 저장하는 행위이기도 합니다. 마찬가지로, 어떤 정보를 어떻게 저장할지, 어떤 정보를 기억할지, 그리고 기억의 어느 부분을 잊거나 삭제할지 선택해야 하는 경우가 종종 있습니다. 이러한 모든 방법론과 선택은 에이전트의 행동에 중요한 영향을 미칩니다. 그림 4-2에서 볼 수 있듯이, 기억을 업데이트하고 사용하는 것은 중간 정보를 신중하게 처리해야 하는 반복적인 과정입니다.
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.