May 2025
Beginner to intermediate
62 pages
41m
Japanese
この作品はAIを使って翻訳されている。ご意見、ご感想をお待ちしている:translation-feedback@oreilly.com
このモデルの各レイヤーを、組み込みエージェントとデータ収集メソッドから見ていこう。
インスツルメンテーションは、ソフトウェアがランタイムコンポーネントからテレメトリを生成するための本質的な手段である。このテレメトリは、エージェントを介して様々なコンポーネントから収集され、集計のためにデータコレクターに送られ、さらに分析システムに送信される。
ロギングは、すべてのプログラミング言語、アプリケーション、システムに実装されている、基本的でほぼ普遍的な機能である。エンドユーザからハードウェアレベルのアクティビティまで、すべてを追跡するログが、コンピュータシステムのいたるところに飛び交っている。
現在でも、多くのログはローカルに保存され、アクティビティ分析やトラブルシューティングが必要なときだけアクセスされる。やがて、Splunk(2003年)のような技術によって、分析のためにすべてのログを中央の場所に送信するという考えが生まれた(Braithwaite 2023年)。その場合でも、ログ収集は従来からバッチ実装で十分であり、例えば毎日のログファイルをバンドルして出荷していた。
これらはもともと単純なハブ&スポークトポロジとして実装され、エンドポイントにエージェントが配置され、テレメトリは分析のために共通のリポジトリに送られる。
リアルタイムの可観測性を確保するためには、イベントが発生すると、その場でログデータを収集し、転送することが不可欠である。基本的には、イベントの発生から数秒から数ミリ秒以内に中央システムに報告されるイベントのストリームを提供する必要がある。
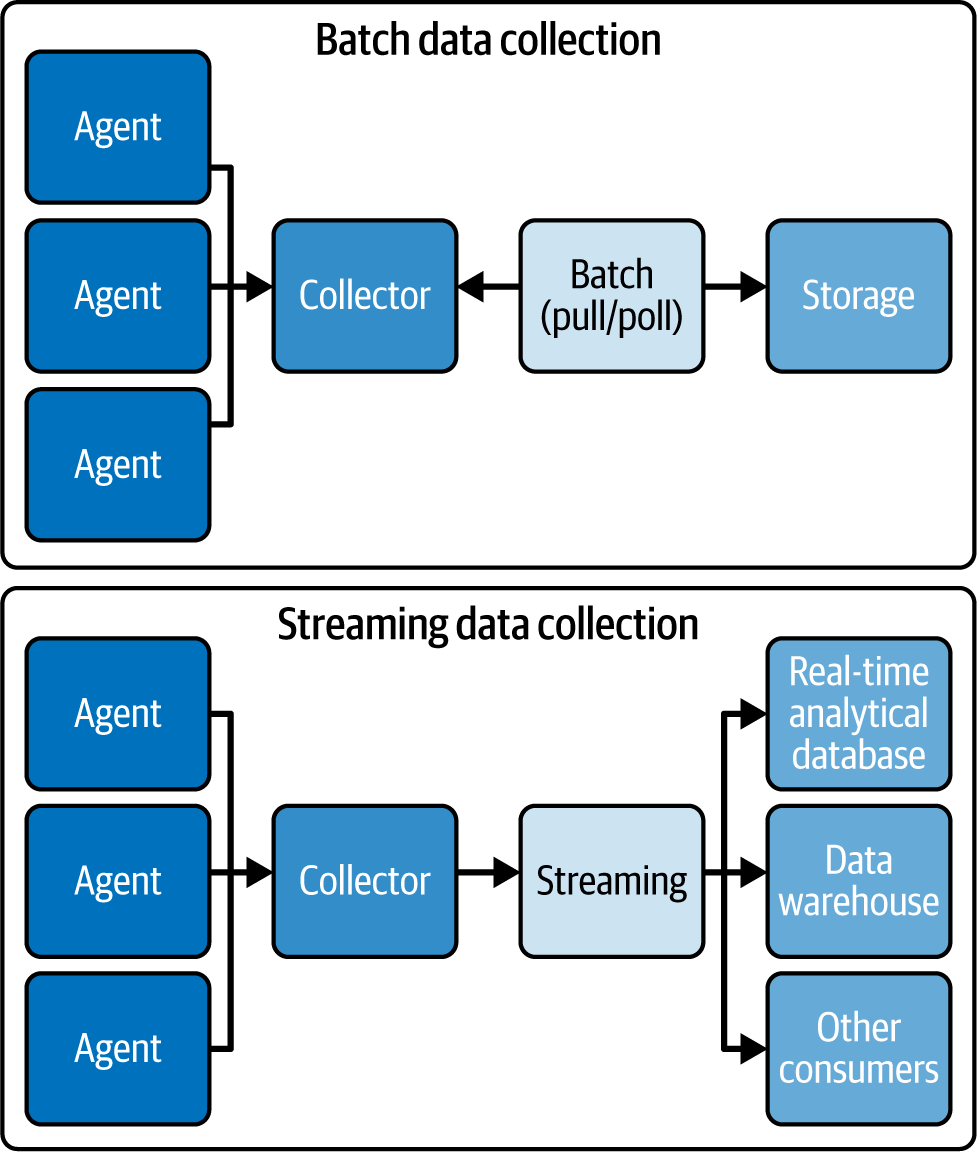
バッチアップロードは、定期的に、おそらく1時間に1回、または1日に1回行われ、単一のデータストレージターゲットにデータを送信する。対照的に、データストリーミングは1秒間に何度も発生し、すべてのエージェントを合わせると1秒間に何百万ものイベントが発生する可能性があり、複数のダウンストリームコンシューマが存在する。そのため、Apache Kafkaのようなストリーミング・データ・ソリューションは、遠隔測定コレクターとストレージ層の間に実装される。ストリーミングデータは様々なトピックに送信され、様々なダウンストリームコンシューマがサブスクライブすることができる。
ロギングと同じ進化がメトリックとトレースにも見られ、その結果、様々な種類の遠隔測定用のエージェントとデータ収集ツールがカンブリア爆発的に増えている。
概念的には、OTel はテレメトリを交換するための共通プロトコルを提供する。しかし、インスツルメンテーション、エージェント、コレクター・ツールは非常に差別化された分野であり、今後も存在するだろう。Fluentd、Fluent Bit、Jaeger、CloudWatch、Datadogの最新バージョンは全てOTelをサポートしているが、だからといって、それらがコモディティというわけではない。それらは互いにドロップインで置き換えられるものではない。 ...
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.