May 2025
Beginner to intermediate
62 pages
41m
Japanese
この作品はAIを使って翻訳されている。ご意見、ご感想をお待ちしている:translation-feedback@oreilly.com
オープンソースの収集レイヤーの実装はオプションだが、特にスケールで演算子する場合には推奨されるステップだ。開発を始めたばかりであったり、小規模で仕事をしているのであれば、コレクションを完全にスキップして、テレメトリをデータリポジトリに直接書き込むこともできる。しかし、システムのフリートを管理するような大企業では、最初からスケールを計画する必要がある。
そのために、エージェントからのテレメトリを集約してデータリポジトリにエクスポートできるOpenTelemetryのCollectorのような単なるコレクターを実装することもできるし、データストリーミングテクノロジーを追加して、より良いスケールとボリュームでのデータ管理ができるようにすることもできる。
収集の実装には、1 つ以上のコレクタが管理対象システムからデータを収集するファンアウトアーキテクチャと、コレクタがプロデューサとして機能し、収集したテレメトリをダウンストリームのコンシューマに送信して、保存、処理、分析できるデータストリーミング(またはメッセージキューイング)ソリューションが必要である(図 4-1)。幸運なことに、この機能は OTel コレクターに組み込まれており、Kafka Exporter として動作する。
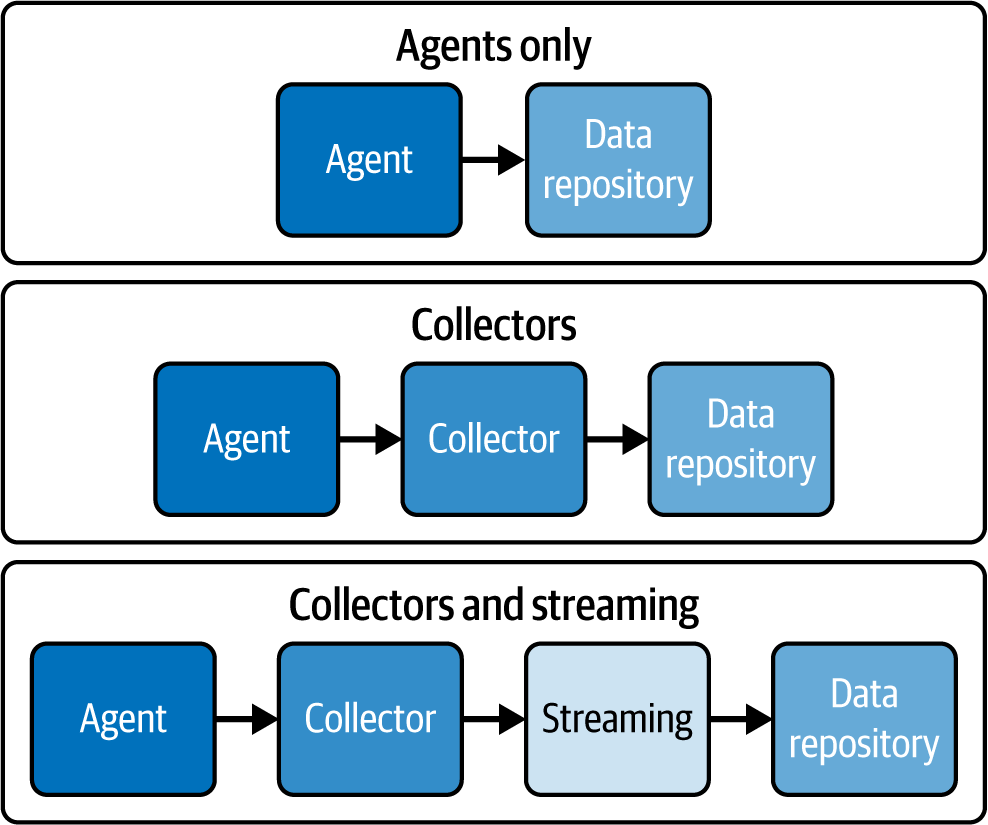
エージェントモードでは、コレクターはサイドカーのように密結合され、テレメトリーを収集するアプリケーションと同じホストに置かれる。ゲートウェイモードでは、コレクターは分離しており、複数のエージェントから流れてくるテレメトリを処理する。そのため、ロードバランシング、処理、集中ポリシー管理など、異なるアーキテクチャをサポートすることができる(Villela 2024)。 必要に応じて独立してスケールアップ(またはスケールダウン)したり、異なるタイプのテレメトリを処理するために、複数のコレクタが必要になることがある(OpenTelemetry 2025 "Scaling the Collector")。
遠隔測定を管理する際の第一の防御行は、メトリックを削除したり、フィルタリングや集約などでカーディナリティを最小化することで、単純に作業を減らすことである。
遠隔測定量を管理する際の次の行はサンプリングである(Dogan 2018; OTel 2024)。すべての詳細なイベントを中央リポジトリに送る必要があるのか、それとも代表的なサブセットだけで十分なのか?サンプリングには、ヘッドサンプリングやテールサンプリングだけでなく、ダウンサンプリングなど、さまざまな戦略が存在する。ダウンサンプリングは、解像度を犠牲にしてメトリックの量を減らすために使用される。トレースは、ヘッド・サンプリングと ...
Read now
Unlock full access


 O’Reilly covers everything we've got, with content to help us build a world-class technology community, upgrade the capabilities and competencies of our teams, and improve overall team performance as well as their engagement.I wanted to learn C and C++, but it didn't click for me until I picked up an O'Reilly book. When I went on the O’Reilly platform, I was astonished to find all the books there, plus live events and sandboxes so you could play around with the technology.I’ve been on the O’Reilly platform for more than eight years. I use a couple of learning platforms, but I'm on O'Reilly more than anybody else. When you're there, you start learning. I'm never disappointed.I'm always learning. So when I got on to O'Reilly, I was like a kid in a candy store. There are playlists. There are answers. There's on-demand training. It's worth its weight in gold, in terms of what it allows me to do.